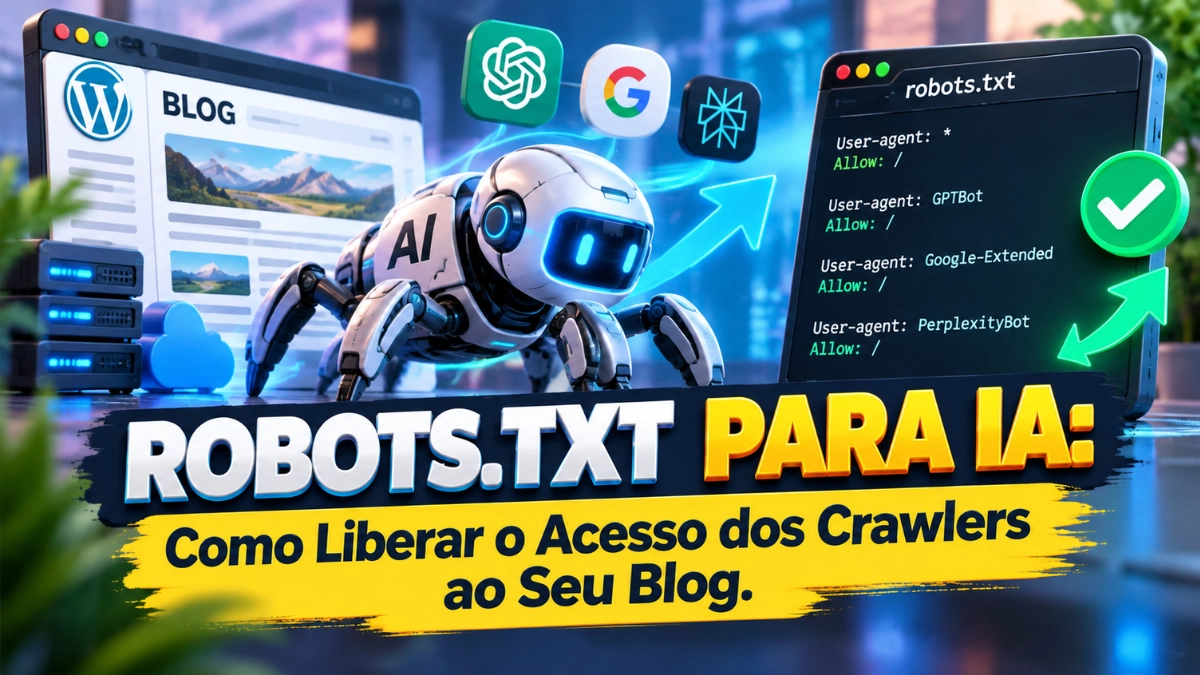
O arquivo robots.txt sempre foi uma parte importante da configuração técnica de sites e blogs, principalmente para controlar o acesso dos mecanismos de busca às páginas de um site. Com o crescimento da inteligência artificial e dos mecanismos de busca baseados em IA, esse arquivo passou a ganhar uma nova importância.
Hoje, empresas como OpenAI, Anthropic, Perplexity, Google, Meta e Amazon utilizam diferentes crawlers e agentes para acessar conteúdos disponíveis na internet. Dependendo do serviço, esses rastreadores podem ser utilizados para pesquisa na web, recuperação de informações solicitadas pelos usuários, desenvolvimento de modelos de inteligência artificial ou outros recursos relacionados a IA.
Por isso, quem trabalha com SEO e GEO pode verificar se o seu robots.txt está permitindo o acesso dos principais crawlers de inteligência artificial.
É importante deixar claro que permitir esses rastreadores não garante que um artigo será citado pelo ChatGPT, Claude, Perplexity ou outro sistema de IA. O robots.txt funciona como uma regra de acesso. Ele pode impedir que determinados crawlers acessem o conteúdo quando há uma regra de bloqueio.
Neste artigo, você vai entender o que é o robots.txt, como ele funciona, quais são seus benefícios e como configurar o arquivo para permitir o acesso de diferentes crawlers relacionados à inteligência artificial.
O que é o robots.txt?
O robots.txt é um arquivo de texto colocado na raiz de um site para informar aos crawlers quais partes do site podem ou não ser rastreadas.
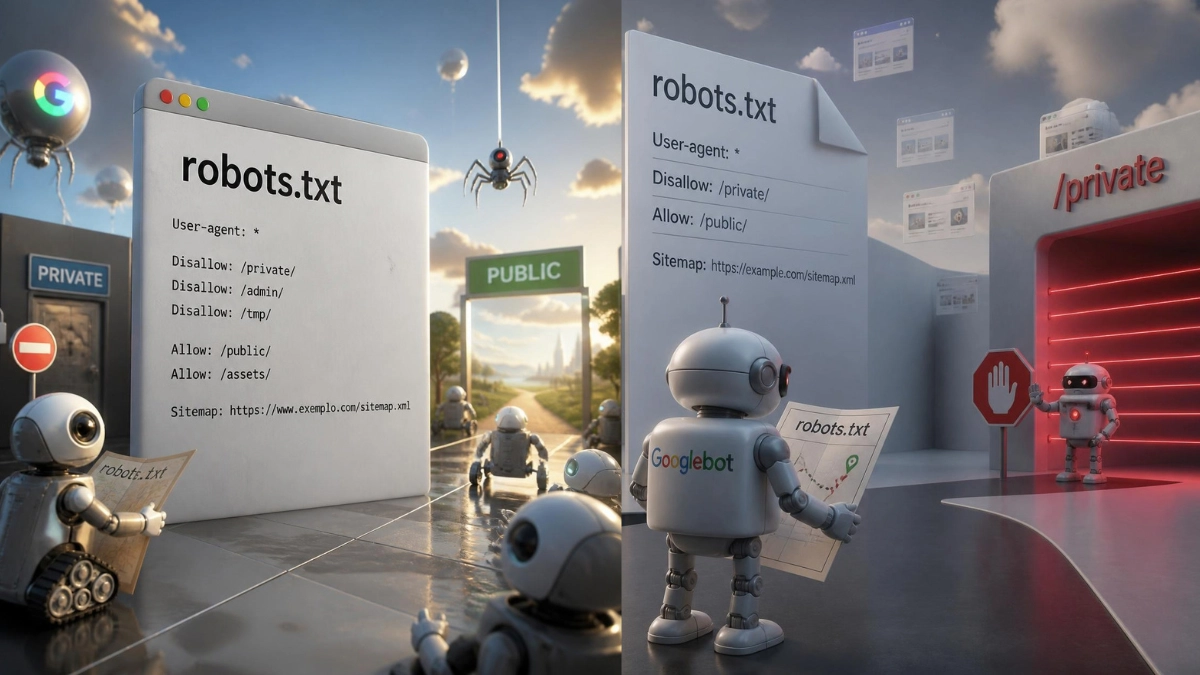
Em um site WordPress, normalmente ele pode ser acessado em:
https://seusite.com.br/robots.txt
O arquivo utiliza regras como User-agent, Allow e Disallow para indicar quais rastreadores devem seguir determinadas permissões.
O Google explica que os crawlers consultam o robots.txt antes de rastrear um site para verificar quais áreas podem ser acessadas. O arquivo também pode conter uma diretiva Sitemap indicando a localização do sitemap do site.
Um exemplo simples seria:
User-agent: *
Allow: /
Nesse caso, o * representa todos os crawlers que não possuem uma regra específica aplicável e o Allow: / indica que o acesso à raiz e aos caminhos do site não está sendo bloqueado por essa regra.
Para que serve o robots.txt?
O principal objetivo do robots.txt é controlar o rastreamento.
Ele pode ser utilizado para permitir ou bloquear o acesso de determinados crawlers a determinadas áreas do site.
Por exemplo:
User-agent: *
Disallow: /admin/
Essa regra informa que o caminho /admin/ não deve ser rastreado pelo grupo de crawlers identificado por *.
Também é possível criar regras específicas para determinados crawlers.
User-agent: GPTBot
Disallow: /
Nesse exemplo, o acesso do GPTBot ao site inteiro está sendo bloqueado.
Da mesma forma, podemos fazer o contrário:
User-agent: GPTBot
Allow: /
Nesse caso, não há bloqueio para esse crawler no caminho indicado.
O funcionamento exato das regras pode variar de acordo com a implementação de cada crawler, por isso é importante consultar a documentação oficial de cada empresa quando estiver configurando regras específicas.
Qual é a importância do robots.txt para GEO?
GEO, ou Generative Engine Optimization, envolve práticas voltadas à presença e à compreensão de conteúdos por mecanismos e sistemas de busca baseados em inteligência artificial.
Nesse contexto, o robots.txt não deve ser tratado como uma técnica que automaticamente melhora o conteúdo ou aumenta suas chances de aparecer nas respostas das IAs.
A função dele é mais básica e, ao mesmo tempo, importante: não criar uma barreira de rastreamento para crawlers que você deseja permitir.
Imagine que você produziu um artigo completo sobre determinado assunto, mas seu site possui uma regra no robots.txt bloqueando um crawler utilizado para pesquisa na web.
Nesse cenário, o crawler poderá não conseguir acessar o conteúdo por causa dessa restrição.
Portanto, verificar o robots.txt faz parte da análise técnica de uma estratégia de GEO.
A lógica é simples:
Conteúdo publicado → crawler consegue acessar → sistema pode analisar o conteúdo → conteúdo pode ser considerado em determinados contextos.
Isso não significa que a última etapa acontecerá automaticamente.
Permitir o rastreamento não garante indexação, posicionamento, citação ou tráfego.
O robots.txt melhora a leitura do conteúdo pelas IAs?
Não diretamente.
Essa é uma diferença importante para quem está começando a trabalhar com GEO.
O robots.txt não modifica o texto do artigo, não melhora sua estrutura semântica e não ensina uma inteligência artificial a interpretar melhor o conteúdo.
Ele controla o acesso dos crawlers.
Uma forma mais correta de explicar isso é:
O robots.txt pode remover uma barreira técnica ao rastreamento do conteúdo por determinados crawlers de IA.
A qualidade da compreensão do conteúdo depende de vários outros fatores, como estrutura do HTML, clareza das informações, contexto, qualidade do conteúdo, links internos, dados estruturados quando aplicáveis, autoridade, relevância e diversos outros sinais utilizados por cada sistema.
Por que permitir crawlers de inteligência artificial?
Existem diferentes motivos pelos quais uma empresa pode disponibilizar crawlers específicos para acesso ao seu conteúdo.
Alguns estão relacionados ao treinamento de modelos.
Outros estão relacionados à pesquisa na web.
Também existem crawlers utilizados para recuperar uma página quando um usuário solicita informações relacionadas a determinado endereço.
Essa diferenciação é importante porque não existe um único “robô das IAs”.
Cada empresa pode utilizar diferentes agentes para finalidades diferentes.
Veja, você pode gostar de ler também sobre: O que é o arquivo llms.txt e como configurar no WordPress além do Rank Math
Principais crawlers relacionados à inteligência artificial
A seguir estão alguns dos principais agentes que podem aparecer em uma estratégia de configuração de robots.txt.
GPTBot
O GPTBot é um crawler associado à OpenAI e está relacionado à coleta de conteúdo da web para desenvolvimento de modelos.
Se o objetivo do proprietário do site for permitir esse tipo de acesso, pode ser adicionada uma regra específica:
User-agent: GPTBot
Allow: /
É importante não confundir esse crawler com os agentes utilizados pela OpenAI para pesquisa ou acesso a páginas solicitado pelo usuário.
OAI-SearchBot
O OAI-SearchBot está relacionado à pesquisa na web utilizada pelos produtos da OpenAI.
Por isso, para uma estratégia voltada à descoberta e recuperação de conteúdo em mecanismos de pesquisa baseados em IA, ele merece atenção.
A regra pode ser:
User-agent: OAI-SearchBot
Allow: /
O objetivo aqui é não bloquear o acesso desse crawler às páginas do site.
ChatGPT-User
O ChatGPT-User é utilizado em situações relacionadas a solicitações feitas pelos usuários.
Quando um usuário fornece um endereço ou solicita informações que podem exigir acesso a uma página da web, esse tipo de agente pode estar envolvido no processo.
A configuração seria:
User-agent: ChatGPT-User
Allow: /
É importante entender que permitir esse agente não significa que o ChatGPT passará a utilizar automaticamente todas as páginas do seu site.
Significa que você não está criando uma regra no robots.txt para bloquear esse acesso.
Crawlers da Anthropic
A Anthropic também utiliza diferentes agentes para finalidades distintas.
Entre eles estão ClaudeBot, Claude-SearchBot e Claude-User.
A própria Anthropic explica que utiliza diferentes bots para coleta de conteúdo da web, pesquisa e recuperação de conteúdo solicitada pelos usuários. A empresa também informa que seus bots respeitam as diretivas do robots.txt.
ClaudeBot
O ClaudeBot está relacionado à coleta de conteúdo da web que pode contribuir para o desenvolvimento de modelos de IA.
Para permitir o acesso:
User-agent: ClaudeBot
Allow: /
Claude-SearchBot
O Claude-SearchBot está relacionado à navegação e pesquisa na web utilizada para melhorar os resultados de busca do Claude.
Para permitir:
User-agent: Claude-SearchBot
Allow: /
A Anthropic informa que bloquear esse agente impede seu sistema de rastrear o conteúdo para determinadas finalidades relacionadas à pesquisa.
Claude-User
O Claude-User está relacionado a acessos realizados em resposta a solicitações dos usuários.
A configuração pode ser:
User-agent: Claude-User
Allow: /
Crawlers do Perplexity
O Perplexity também utiliza agentes específicos para acessar conteúdo da web.
Entre os principais estão PerplexityBot e Perplexity-User.
PerplexityBot
O PerplexityBot é o crawler de pesquisa do Perplexity.
Para permitir o acesso:
User-agent: PerplexityBot
Allow: /
O próprio Perplexity informa que seu crawler de pesquisa respeita os limites explícitos definidos pelos sites em seus arquivos robots.txt.
Perplexity-User
O Perplexity-User está relacionado a situações em que o acesso ocorre em resposta a solicitações dos usuários.
A regra pode ser:
User-agent: Perplexity-User
Allow: /
Google-Extended
O Google-Extended merece uma explicação especial porque existe bastante confusão sobre ele.
Ele não é simplesmente outro crawler do Google.
O Google descreve o Google-Extended como um token de controle utilizado no robots.txt para permitir que os proprietários de sites gerenciem determinados usos do conteúdo rastreado pelo Google relacionados ao treinamento de futuras gerações de modelos Gemini e a processos de grounding em produtos específicos.
Uma configuração permitindo o acesso seria:
User-agent: Google-Extended
Allow: /
Entretanto, existe uma informação muito importante.
O próprio Google informa que o Google-Extended não afeta a inclusão de um site na Pesquisa Google e não é utilizado como sinal de classificação na Pesquisa.
Portanto, não é correto dizer que colocar Google-Extended no robots.txt fará seu site aparecer melhor no Google ou automaticamente nas Visões Gerais de IA.
Para SEO tradicional e presença na Pesquisa Google, continuam sendo importantes as regras e práticas gerais de rastreamento, indexação e qualidade do Google.
Applebot-Extended
O Applebot-Extended está relacionado aos controles utilizados pela Apple para determinados usos do conteúdo por seus sistemas de inteligência artificial.
Uma configuração permitindo o acesso pode ser:
User-agent: Applebot-Extended
Allow: /
Como ocorre com os demais agentes, permitir o rastreamento não significa que seu conteúdo será automaticamente utilizado ou citado por um produto específico.
meta-externalagent
A Meta também possui agentes relacionados ao acesso automatizado a conteúdos públicos da web.
Uma configuração de permissão pode ser:
User-agent: meta-externalagent
Allow: /
O importante é entender que cada plataforma possui seus próprios sistemas, regras e finalidades de rastreamento.
Por isso, não é recomendável tratar todos esses crawlers como se fossem exatamente iguais.
Amazonbot
O Amazonbot também pode ser encontrado em configurações de robots.txt relacionadas aos serviços da Amazon.
Caso você queira permitir seu acesso:
User-agent: Amazonbot
Allow: /
Novamente, a permissão apenas evita que o robots.txt seja utilizado para bloquear esse agente.
CCBot e Common Crawl
O CCBot está associado ao Common Crawl, projeto que disponibiliza grandes conjuntos de dados coletados da web para pesquisa e outras finalidades.
Uma configuração permitindo o acesso seria:
User-agent: CCBot
Allow: /
O Common Crawl é relevante no contexto de inteligência artificial porque seus conjuntos de dados podem ser utilizados como fonte para diferentes projetos e sistemas.
Isso não significa que permitir o CCBot fará com que seu artigo apareça diretamente no ChatGPT ou em outro mecanismo de IA.
Código completo para liberar os principais crawlers
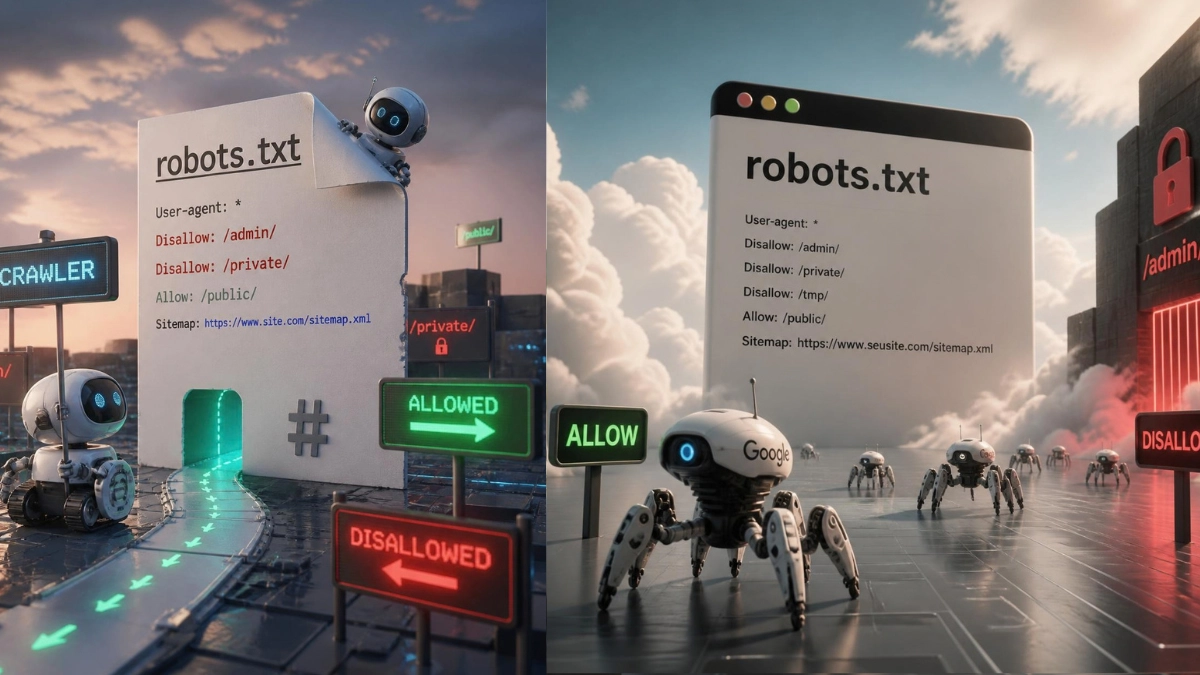
Se você deseja utilizar uma configuração explícita para permitir o acesso desses agentes ao conteúdo do seu site, pode copiar aqui abaixo e utilizar:
User-agent: *
Allow: /

User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Perplexity-User
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

User-agent: meta-externalagent
Allow: /

User-agent: Amazonbot
Allow: /

User-agent: CCBot
Allow: /

Sitemap: https://seusite.com.br/sitemap_index.xml
Substitua https://seusite.com.br/sitemap_index.xml pelo endereço real do sitemap do seu site.
O Google documenta que a diretiva Sitemap deve utilizar uma URL completa e pode ser incluída no robots.txt.
O que significa User-agent: *?
A linha:
User-agent: *
representa um grupo geral de crawlers.
Quando acompanhada por:
Allow: /
ela indica que o site não está criando uma restrição de rastreamento para esse grupo.
Isso é importante porque muitos proprietários de sites acreditam que precisam obrigatoriamente listar todos os crawlers existentes.
Não é necessário fazer isso.
Uma configuração simples como:
User-agent: *
Allow: /
já representa uma política ampla de permissão.
As regras específicas podem ser utilizadas para tratar determinados crawlers de maneira individual.
O Google explica que, quando existem grupos específicos para um determinado user agent, o crawler utiliza o grupo mais específico aplicável, em vez de combinar automaticamente esse grupo com o grupo global *.
Por que utilizar regras específicas para as IAs?
Se User-agent: * já permite o acesso, você pode se perguntar por que listar cada crawler individualmente.
Existem algumas razões.
A primeira é deixar explícita a política de acesso.
A segunda é facilitar futuras alterações.
Por exemplo, você pode querer permitir o acesso de um crawler de pesquisa, mas bloquear posteriormente um crawler destinado a determinada finalidade.
Ao ter regras individuais, fica mais fácil controlar essas situações.
A terceira é facilitar a auditoria técnica do site.
Ao olhar o robots.txt, você consegue identificar rapidamente quais agentes de IA foram considerados na configuração.
Porém, é importante entender que repetir Allow: / para cada crawler não cria, por si só, um benefício de SEO.
Permitir crawlers não significa garantir citações
Esse é provavelmente o ponto mais importante deste artigo.
Colocar:
User-agent: PerplexityBot
Allow: /
não significa:
“Meu artigo agora será citado pelo Perplexity.”
Da mesma forma:
User-agent: OAI-SearchBot
Allow: /
não significa:
“Meu artigo agora aparecerá no ChatGPT.”
O que a configuração faz é remover uma possível restrição de rastreamento.
A decisão de utilizar determinado conteúdo depende de outros processos.
O conteúdo precisa ser acessível, relevante para a consulta, compreensível, útil e compatível com os critérios utilizados pelo sistema.
Além disso, diferentes mecanismos de IA possuem tecnologias e processos próprios.
Robots.txt não substitui SEO
Outro ponto importante é que o robots.txt não substitui uma estratégia de SEO.
Você pode ter um arquivo perfeitamente configurado e ainda assim possuir problemas de indexação, conteúdo, arquitetura, velocidade, links internos ou qualidade.
O robots.txt é apenas uma parte da infraestrutura técnica do site.
Para trabalhar SEO e GEO de maneira mais completa, também é importante cuidar de aspectos como:
Conteúdo original e útil
Produza conteúdo que realmente responda às dúvidas do usuário.
Não crie artigos apenas para inserir palavras-chave.
Estrutura clara
Utilize títulos, subtítulos, parágrafos curtos, listas e uma organização lógica.
Isso facilita a leitura tanto para usuários quanto para sistemas automatizados que precisam interpretar o conteúdo.
Links internos
Utilize links internos relevantes para conectar conteúdos relacionados.
Isso ajuda os mecanismos de busca a entenderem a relação entre as páginas do site.
Autoridade e experiência
Deixe claro quem produziu o conteúdo, principalmente em assuntos nos quais experiência e conhecimento especializado são importantes.
Informações atualizadas
Revise artigos antigos quando informações, ferramentas, preços, funcionalidades ou procedimentos forem alterados.
Sitemap
Mantenha o sitemap atualizado e informe sua localização no robots.txt.
Indexação
Verifique se as páginas que você deseja que sejam encontradas estão realmente indexáveis.
Permitir rastreamento no robots.txt não significa que uma página necessariamente será indexada.
Robots.txt e sitemap são coisas diferentes
É muito comum confundir os dois.
O robots.txt controla regras de rastreamento.
O sitemap apresenta uma lista de URLs que você deseja comunicar aos mecanismos de busca.
Por isso, os dois podem trabalhar juntos.
Por exemplo:
User-agent: *
Allow: /

Sitemap: https://seusite.com.br/sitemap_index.xml
Nesse caso, você está informando uma política de rastreamento aberta e também indicando onde está o sitemap.
O sitemap não obriga um mecanismo de busca ou sistema de IA a indexar ou utilizar todas as URLs.
Ele funciona como uma forma de descoberta e comunicação das URLs importantes do site.
Onde colocar o robots.txt?
O arquivo deve ficar na raiz do domínio.
Exemplo:
https://seusite.com.br/robots.txt
Não é recomendável colocá-lo em:
https://seusite.com.br/blog/robots.txt
se a intenção for controlar o rastreamento do domínio inteiro.
O Google informa que as regras do arquivo se aplicam ao host, protocolo e porta em que o robots.txt está hospedado.
Como verificar o robots.txt do seu site
Depois de configurar o arquivo, abra:
https://seusite.com.br/robots.txt
Verifique se o conteúdo exibido é realmente um arquivo de texto com as regras.
Também é importante conferir se você não possui regras acidentais como:
Disallow: /
Essa regra pode bloquear o rastreamento de todo o site para o grupo ao qual ela se aplica.
Também verifique se plugins, configurações do WordPress, CDN ou ferramentas de segurança não estão alterando o comportamento do arquivo.
Cuidado ao copiar configurações de robots.txt
O robots.txt é um arquivo simples, mas uma configuração incorreta pode criar problemas.
Antes de colocar uma regra Disallow, entenda exatamente qual caminho será bloqueado.
Também não utilize Disallow como mecanismo de segurança.
O robots.txt não é uma ferramenta para proteger informações privadas.
Uma URL bloqueada pode continuar sendo conhecida por outros meios e, dependendo do mecanismo de busca, a própria URL pode aparecer sem o conteúdo rastreado.
O Google explica que bloquear o rastreamento pelo robots.txt não é a mesma coisa que impedir completamente a indexação de uma URL.
O robots.txt é obrigatório para GEO?
Não.
Você não precisa criar um arquivo enorme com todos os crawlers de IA existentes para trabalhar GEO.
O mais importante é não bloquear acidentalmente os agentes que você deseja permitir.
Além disso, os crawlers e suas funções podem mudar com o tempo.
Novos agentes podem surgir, agentes existentes podem mudar de finalidade e empresas podem atualizar suas políticas.
Por isso, uma boa prática é revisar periodicamente o robots.txt e consultar a documentação oficial das plataformas relevantes.
Veja, você pode gostar de ler também sobre: Como o AI Overviews Está Mudando o SEO dos Blogs
Uma configuração aberta é sempre melhor?
Não necessariamente.
Essa decisão depende dos objetivos do proprietário do site.
Se você deseja permitir que determinado sistema rastreie seu conteúdo, pode fazer sentido não bloqueá-lo.
Por outro lado, alguns proprietários podem decidir restringir determinados crawlers por questões relacionadas a licenciamento, treinamento de modelos, uso de conteúdo, consumo de recursos do servidor ou estratégia própria de distribuição.
Não existe uma única configuração que seja obrigatoriamente correta para todos os sites.
O importante é saber exatamente o que cada regra está permitindo ou bloqueando.
O que essa configuração pode ajudar em uma estratégia de GEO?
Uma configuração como a apresentada neste artigo pode contribuir para uma estratégia técnica de GEO porque evita que o próprio robots.txt impeça o acesso de determinados crawlers.
Isso é especialmente relevante para agentes voltados à pesquisa e recuperação de informações.
A Anthropic, por exemplo, informa que seus bots respeitam as diretivas do robots.txt e que o Claude-SearchBot é utilizado para navegação e pesquisa na web.
O Perplexity também informa que seu crawler de pesquisa respeita os limites definidos pelos sites em seus arquivos robots.txt.
Portanto, o raciocínio é simples:
Se você quer que determinados crawlers possam acessar seu conteúdo, não faz sentido bloqueá-los acidentalmente no robots.txt.
Mas isso é apenas a parte técnica do processo.
A qualidade e a relevância do conteúdo continuam sendo fundamentais.
Conclusão
O robots.txt continua sendo um arquivo importante para qualquer site que trabalhe com SEO, e a expansão dos mecanismos de busca e sistemas de inteligência artificial torna ainda mais importante entender como ele funciona.
Para uma estratégia de GEO, vale verificar se os principais crawlers relacionados às plataformas que você deseja alcançar conseguem acessar o conteúdo do seu site.
A configuração:
User-agent: *
Allow: /

User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Perplexity-User
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

User-agent: meta-externalagent
Allow: /

User-agent: Amazonbot
Allow: /

User-agent: CCBot
Allow: /

Sitemap: https://seusite.com.br/sitemap_index.xml
é uma forma explícita de informar que esses agentes não estão sendo bloqueados pelo robots.txt.
Entretanto, é fundamental entender a função real desse arquivo.
Ele não melhora sozinho a qualidade do conteúdo, não garante posicionamento e não garante citações nas respostas das inteligências artificiais.
O objetivo é garantir que o seu site não esteja criando uma barreira técnica para determinados crawlers.
Depois disso, o trabalho de GEO continua dentro do próprio conteúdo, com informações úteis, estrutura clara, contexto, autoridade, experiência, links internos, boa arquitetura e uma página tecnicamente acessível.
Para quem deseja preparar um blog para a nova realidade das pesquisas com inteligência artificial, o robots.txt é apenas uma das peças dessa estratégia, mas é uma peça que vale a pena verificar.
Olá, me chamo Kildary Oliver e sou especialista em criação de blogs em WordPress e monetização com Google AdSense desde 2018. Já ajudei mais de 300 blogs de alunos a serem aprovados no AdSense e, atualmente, reúno mais de 28 mil inscritos no meu canal do YouTube e mais de 10 mil alunos nos meus cursos.
Acompanho de perto as mudanças do Google e do SEO e busco aplicar as estratégias mais atuais em meus projetos, com formação recente em GEO e Agentes de IA aplicados à criação de conteúdo.